
Synthetische Datengenerierung & Computer Vision
F&E · PrüfstandsdatenHinderniserkennung am Gleis: synthetische Trainingsdaten
Echtes Führerstandsvideo · Ego-Path · weltfeste Platzierung · Polygon-Labels · menschliche Freigabe
Python · OpenCV · TEP-Net · SDXL · BiRefNet · GroundingDINO + SAM · YOLO-Seg
Zuletzt aktualisiert:
01Problem
Problem: Hindernisbilder im Gleis lassen sich im Feld nicht erheben
Gleishindernisse lassen sich nicht gezielt filmen; daher erzeugen wir synthetische Trainingsdaten zur Hinderniserkennung auf echtem Führerstandsvideo. Ein Detektor, der Steine, Äste oder Tiere auf den Schienen erkennen soll, braucht viele annotierte Frames genau davon. Solche Ereignisse sind selten und gefährlich, und niemand kann für Trainingsdaten ein Hindernis vor einen Zug legen. Die Folge: zu wenige Positivbeispiele und eine schiefe Klassenverteilung.
- 01Echte Hindernisbilder gibt es kaum; das Modell sieht das kritische Ereignis im Training nie
- 02Manuelle Annotation Frame für Frame ist bei Tausenden Frames teuer und fehleranfällig
- 03Ein auf den Bildschirm geklebtes Hindernis fährt mit dem Zug mit und wächst nicht natürlich; das Modell lernt eine Bewegung, die es nicht gibt
- 04Ein mit klassischer Bildverarbeitung bestimmter Gleisbereich kann auf das Nachbargleis oder einen parallelen Weg rutschen; Hindernisse landen an der falschen Stelle, und der gesamte Datensatz ist falsch
- 05Gelangen synthetische Bilder in Validierungs- oder Testdaten, wird die Modellleistung zu hoch gemessen
02Pipeline-Kontext und Grundbegriffe
03Warum einfache Ansätze nicht reichten
- 01Verankerung im Bildraum: Ein relativ zum Bildschirm platziertes Hindernis (etwa „bei 60 % der sichtbaren Schiene") kommt nie näher. Das war die einzige Ursache dreier wiederkehrender Fehler früherer Versuche: Das Hindernis bleibt nicht stehen, wächst nicht natürlich und fährt mit dem Zug mit.
- 02Texturbasierte Gleismaske: Sie konnte die Schienen nicht vom Nachbargleis und einem parallelen Schotterweg unterscheiden und lag in 62,6 % der Frames des Testclips falsch.
- 03Box-Labels: Ein Segmentierungsmodell braucht Polygone; Box-Labels passierten unseren Trainingsdatensatz-Builder nicht.
- 04Eine einzige Sichtbarkeitsschwelle: Wurde der Teil außerhalb des Bildes als „nicht sichtbar" gezählt, blieb das Hindernis genau dann ohne Label, wenn der Zug ihm am nächsten war.
- 05Offener Regelkreis: Das Modell meldete, bei welcher Klasse es schwach war, doch dieser Bericht steuerte die Erzeugung nicht.
04So funktioniert die Pipeline
Letterbox-Balken werden entfernt, der Ego-Path wird pro Frame mit TEP-Net bestimmt, und jeder Clip wird mit einem portablen 720p-Proxy gespeichert
→ Der Korridor für Hindernisse ist für jeden Frame bekannt; ein Clip-Ordner lässt sich auf jedem Rechner öffnen
Qualitätsprüfung ohne Labels: Das eigene Gleis muss das Bild unten mittig verlassen, die Korridormitte im unteren Band muss also zwischen 0,35–0,65 liegen; liegen mehr als 5 % der Frames außerhalb, wird der Clip verworfen
→ Masken auf dem Nachbargleis gelangen nicht in die Daten. In 1.672 Frames desselben Clips: klassische CV 62,6 % Frames außerhalb des Bands, Ego-Path 0 %
Verfolgbare Bodenpunkte werden mit KLT verfolgt; die zurückgelegte Strecke wird über den Kehrwert des Abstands zur Horizontlinie (1/q) gemessen
→ Weder Brennweite noch Kamerahöhe noch Zuggeschwindigkeit nötig; funktioniert mit unkalibriertem Video
Ein Hindernis wird über den Frame definiert, in dem der Zug es erreicht; Größe und seitlicher Versatz in Spurweiten, die Farbanpassung wird einmal bei der Platzierung berechnet
→ Das Hindernis bleibt fest in der Szene und wächst bei Annäherung; R² von 1/Höhe über der Zeit 0,985–0,996 bei 8 Hindernissen
Labels sind YOLO-Seg-Polygone aus dem sichtbaren Alpha des Hindernisses; von einem näheren Hindernis verdeckte Teile fallen heraus, und das Verlassen des Bildes löscht das Label nicht mehr
→ In derselben Validierungsszene sank die Zahl der Hindernisinstanzen, die beim Verlassen des Bildes ohne Label blieben, von 96 auf 11. Der Rest sind die letzten ein bis zwei Frames, bevor ein Hindernis das Bild ganz verlässt; der sichtbare Teil ist kleiner als 10 px
Ist das Modell bei einer Klasse oder Distanz schwach, schlägt die Richtlinie ein Szenario vor (im Gleis, fern und klein mit 10–40 px, neben dem Gleis); die Erzeugung läuft klassenbalanciert
→ Synthetische Daten zielen auf eine gemessene Schwäche, statt zufällig erzeugt zu werden
Fehlerhafte Bilder werden auf Prüfbögen verworfen; nur freigegebene gehen ins Training. Synthetische Bilder gelangen nicht in Validierungs- oder Testdaten; ab 25 % synthetischem Anteil warnt der Builder, über 33 % startet die Oberfläche kein Training
→ Modellwerte werden nicht durch synthetische Daten geschönt; Herkunft und Freigabe jedes Bildes sind protokolliert
05Getesteter Ansatz → gewählter Ansatz
Synthetische Datenerzeugung mit automatischer Annotation
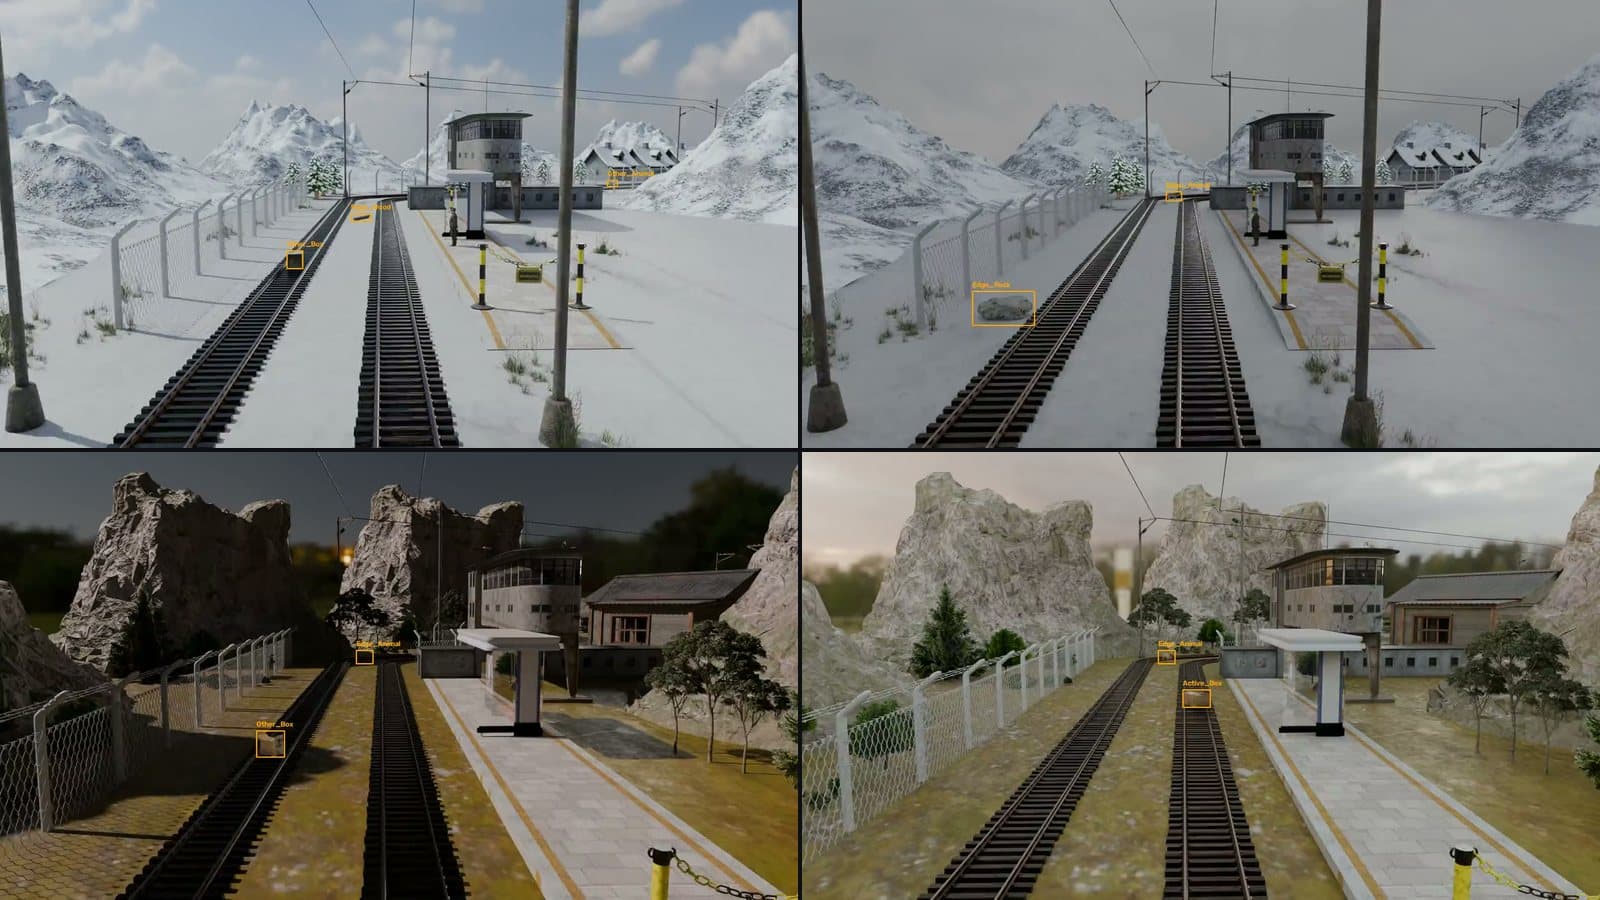
Dieses Video zeigt einen zweiten Erzeugungsweg für die Hinderniserkennung am Gleis: Die gesamte Szene entsteht in Blender. Er ist vom Weg über echtes Führerstandsvideo getrennt, den diese Seite beschreibt. Die Bounding-Boxen der in der Szene platzierten Objekte werden nicht von Hand gezeichnet, sie entstehen automatisch beim Rendern. Die Boxen im Video sind genau diese automatische Ausgabe.
Das Material ist synthetisch und keine Aufzeichnung einer Feldinspektion. Ziel ist ein annotierter Trainingsdatensatz für Szenarien, in denen echte Datenerhebung teuer und gefährlich ist.
06Was wir mit dieser Pipeline leisten können
Für ein Bahnprojekt mit Frontkamera-Aufnahmen können wir die seltenen Szenarien erzeugen, die ein Hindernisdetektor braucht, Ihre echten Daten annotieren und einen echten Testdatensatz aufbauen, der den Beitrag synthetischer Daten messbar macht. Die folgenden Fähigkeiten sind in dieser Arbeit aufgebaut und lauffähig; in einem Kundenprojekt werden Umfang, Klassen und Videoquelle projektbezogen festgelegt.
- 01Analyse der Videoverwendbarkeit: Wir bestimmen den Gleisbereich Frame für Frame und berichten mit einem label-freien Test, welche Clips sich für die Hinderniserzeugung eignen
- 02Klassenbalancierte synthetische Trainingsdaten mit YOLO-Seg-Polygon-Labels in den benötigten Hindernisklassen: im Gleis, fern und klein (10–40 px), neben dem Gleis
- 03Annotation echter Daten mit Active-Learning-Schleife: Vorannotation mit GroundingDINO + SAM, menschliche Prüfung, YOLO-Seg-Training, Iterationsberichte je Klasse
- 04Design der Sim-to-Real-Bewertung: von der Erzeugung zurückgehaltene echte Testclips, Grenzen für den synthetischen Anteil und ein nachvollziehbares Freigabeprotokoll
- 05Eine neue Hindernisklasse braucht keine Feldkampagne: Sie entsteht aus einem neuen, auf der GPU erzeugten Asset-Satz; das Compositing läuft auf der CPU
- 06Dieselbe Annotations- und Active-Learning-Infrastruktur wird für Luftraum-Datensätze (Vogel / Drohne) genutzt; die Übertragung eines trainierten Detektors auf Edge-Hardware ist Thema unserer Edge-AI-Pipeline-Fähigkeit
Um Ihren Bedarf an Synthetische Datengenerierung & Computer Vision auf Ihrer eigenen Plattform zu bewerten, planen Sie ein Embedded-Architektur-Audit oder bestimmen Sie Ihre Plattformklasse mit dem System-Anforderungsrechner.
Häufige Fragen
07Häufige Fragen
Warum braucht die Hinderniserkennung am Gleis synthetische Daten?
Weil Hindernisse im Gleis selten und gefährlich sind: Genug annotierte, klassenbalancierte echte Beispiele, um ein Modell zu trainieren, lassen sich im Feld nicht erheben. Synthetische Daten schließen diese Lücke: Sie liefern Frames mit Hindernissen in der benötigten Klasse, Entfernung und Lage zum Gleis. Echte Daten ersetzen sie nicht; ihr Beitrag muss an einem echten Testdatensatz gemessen werden.
Was ist weltfeste Platzierung, und warum ist sie wichtig?
Weltfeste Platzierung heißt: Das synthetische Hindernis ist an die Szene gebunden, nicht an den Bildschirm. Ein Hindernis, das bei einem festen Anteil der sichtbaren Schiene sitzt, bleibt bei Annäherung weder stehen noch wächst es; das Modell lernt eine Bewegung, die es nicht gibt. Wir verfolgen die Tiefe des Hindernisses mit einer einzigen Größe: Es steht fest in der Szene, wächst, während der Zug näher kommt, und verlässt das Bild nach unten. In der Validierung lag das R² von 1/Höhe über der Zeit bei 8 Hindernissen zwischen 0,985 und 0,996.
Ist eine Kamerakalibrierung nötig?
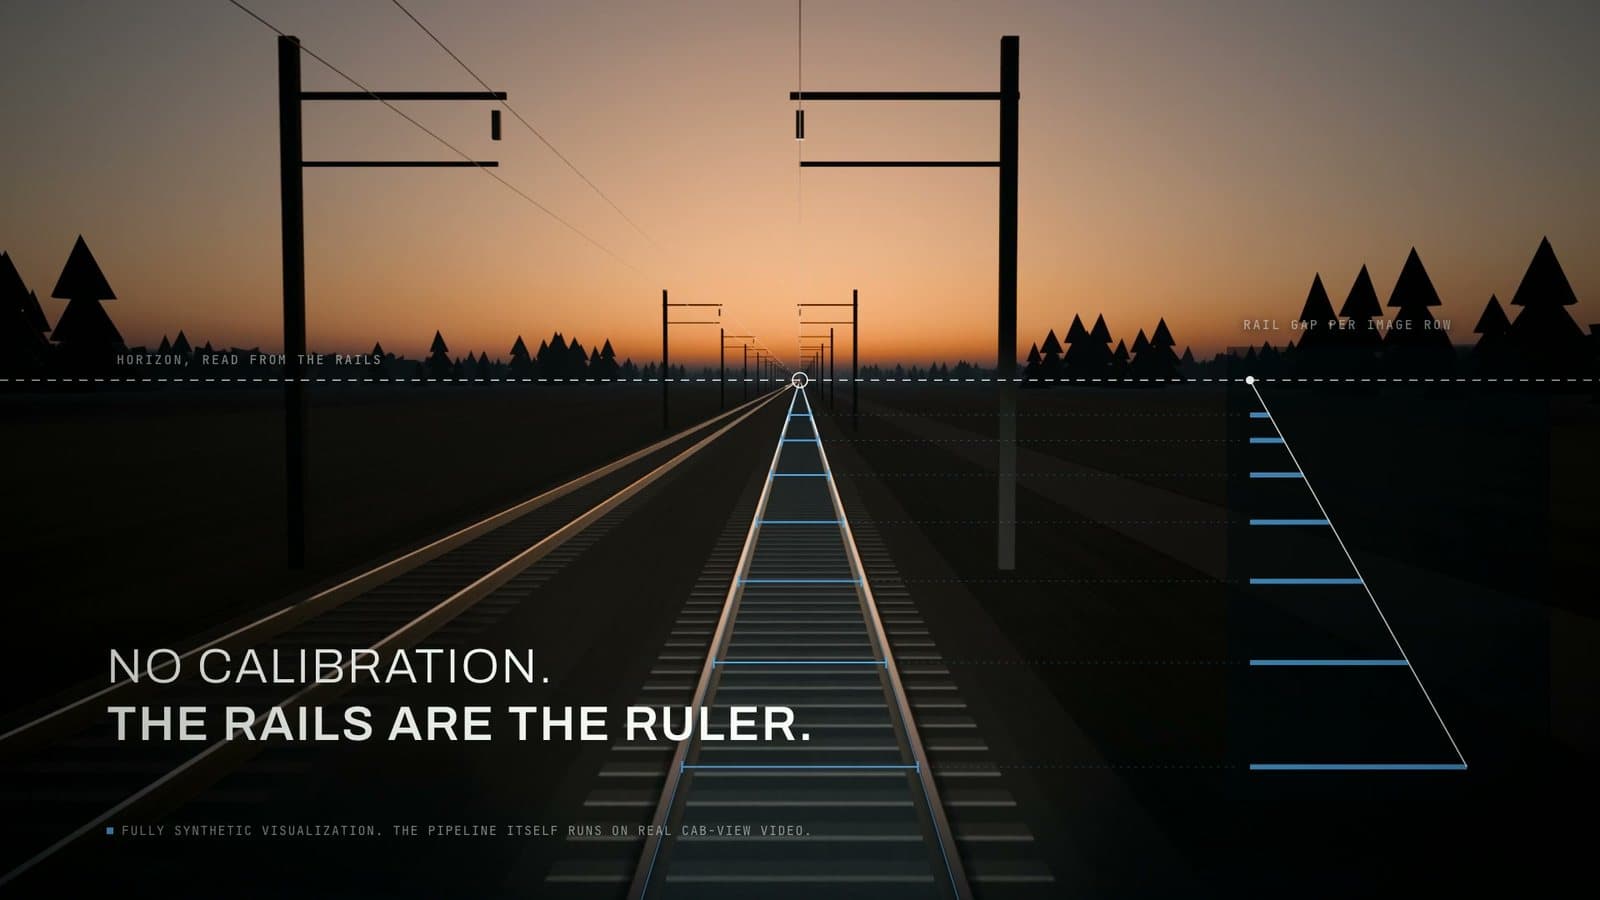
Nein. Die Spurweite im Bild ändert sich linear mit der Bildzeile, daher ergeben sich Horizont und Maßstab direkt aus den Schienen; die zurückgelegte Strecke stammt aus Bodenpunkten, die mit KLT verfolgt werden. Brennweite, Kamerahöhe und Zuggeschwindigkeit kürzen sich aus der Rechnung heraus, deshalb funktioniert das Verfahren auch mit Führerstandsvideo ohne Kalibrierdaten. Die Rechnung setzt eine ebene Bodenfläche voraus; bei starken Neigungswechseln sinkt die Genauigkeit.
Wie entstehen die Labels? Wird etwas von Hand gezeichnet?
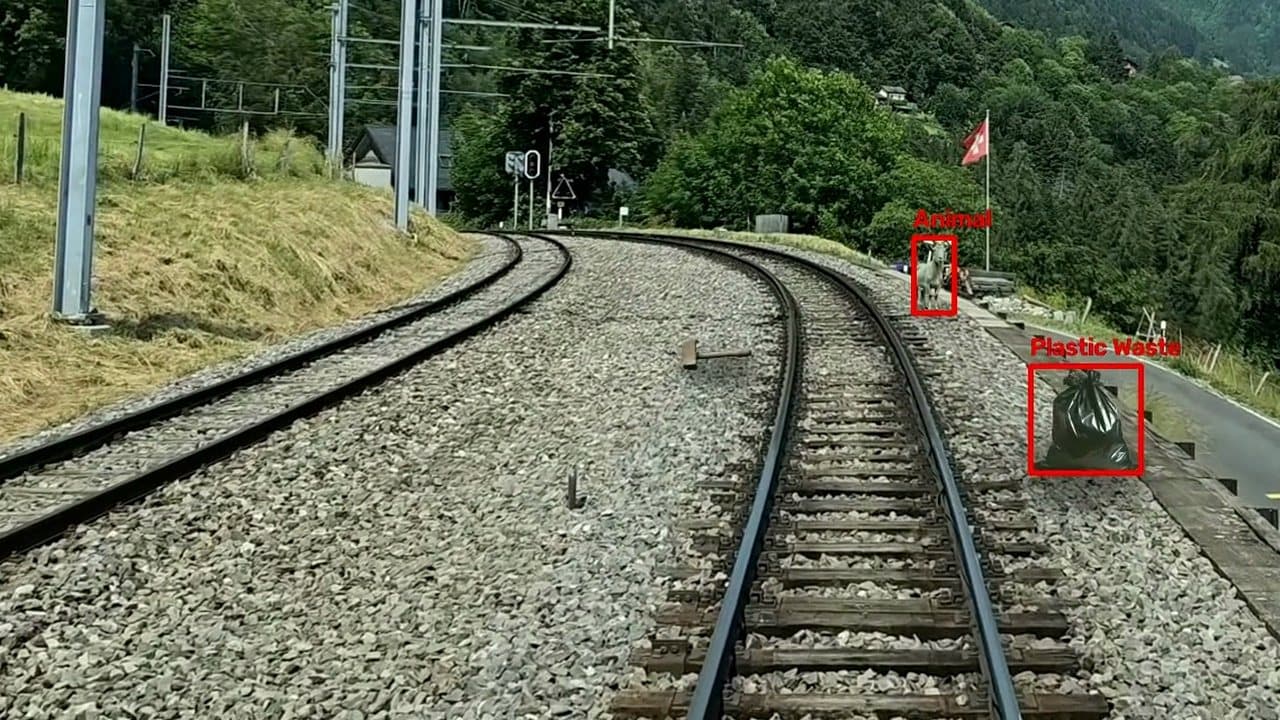
Nichts wird von Hand gezeichnet: Das Label entsteht in dem Moment, in dem das Hindernis platziert wird, aus der Geometrie als YOLO-Seg-Polygon. Das Polygon folgt dem sichtbaren Teil des Hindernisses; von einem näheren Hindernis verdeckte Teile fallen heraus, und das Verlassen des Bildes löscht das Label nicht. Menschliche Arbeit steckt in der Prüfung, nicht im Zeichnen: Fehlerhafte Bilder werden auf Prüfbögen verworfen, und die freigebende Person wird protokolliert.
Können synthetische Daten die Modellwerte schönen?
Bei falschem Aufbau ja; deshalb erzwingt der Code drei Regeln. Synthetische Bilder gehen nur in den Trainingsdatensatz, nie in Validierungs- oder Testdaten. Clips, die als echter Testdatensatz zurückgehalten werden, dienen nie der Erzeugung. Ab 25 % synthetischem Anteil warnt der Builder, über 33 % startet die Oberfläche kein Training.
Welche Hindernisklassen gibt es, und lassen sich neue hinzufügen?
Diese Arbeit umfasst 8 Klassen: Stein, heruntergefallener Ast, Fahrrad/Scooter, Metallteil, Holzbrett, Plastikmüll, Werkzeug und Tier; die Bibliothek enthält 657 Bilder. Eine neue Klasse braucht keine Feldkampagne: Bilder werden mit SDXL erzeugt, mit BiRefNet freigestellt und nach bestandener automatischer Qualitätsprüfung in die Bibliothek aufgenommen. Dieser Schritt braucht eine GPU; Compositing und Annotation laufen auf der CPU.
Wie gut funktioniert das im Feld?
Das haben wir noch nicht gemessen, und vorher veröffentlichen wir keine Zahl. Gemessen haben wir bisher die Korrektheit der Pipeline: Der Gleisbereich liegt auf dem richtigen Gleis, das Hindernis bleibt weltfest, und das Label folgt dem sichtbaren Teil. Der Beitrag synthetischer Daten zur Erkennung wird an echten Testclips gemessen, die von der Erzeugung zurückgehalten und von Hand annotiert werden.
Filme zu diesem Thema
 1:00
Synthetische Daten für die Hinderniserkennung am Gleis: Die Schienen sind das Lineal
 0:27
Wir haben nicht auf den Winter gewartet: eine Bahnszene, vier Bedingungen (synthetische Daten)
 0:20
Automatisch annotierte synthetische Hindernisse auf realen Bahnaufnahmen
Methodik, Messbedingungen und Grenzen
- Dies ist ein F&E-/Fähigkeitsfall, kein geliefertes Kundenprojekt. Alle Zahlen auf dieser Seite hat Spikedge unter den folgenden Bedingungen gemessen.
- Vergleich Gleisbereich: 1.672 Frames eines Führerstandsclips mit Nachbargleis und parallelem Schotterweg (3600×2338, H.264). Metrik: Anteil der Frames, in denen die horizontale Mitte des unteren 10-%-Bands des Korridors außerhalb von 0,35–0,65 liegt. August 2026; am 26. September 2026 mit gleichem Ergebnis wiederholt.
- Weltfeste Verankerung: Validierungsszene mit 8 Hindernissen und 960 Frames auf einem zweiten Clip. R² einer linearen Anpassung von 1/Höhe über der Framenummer, in Frames mit mindestens 10 px Hindernishöhe. Für ein mit konstanter Geschwindigkeit angefahrenes Objekt muss dieser Zusammenhang linear sein. Da die Hindernisgröße aus der gemessenen Eigenbewegung berechnet wird, ist dies eine interne Konsistenzprüfung: Sie zeigt, dass das Hindernis wie ein stehendes Objekt wächst; ein Positionsvergleich mit einem realen Objekt ist sie nicht.
- Hindernisse am Bildrand: In derselben Szene wurden Hindernisinstanzen (Hindernis × Frame) gezählt, die mindestens 10 px hoch waren, aber kein Label trugen: 96 mit der alten Regel, 11 mit der neuen. Alle verbleibenden Instanzen sind die letzten ein bis zwei Frames, bevor ein Hindernis das Bild ganz verlässt; der sichtbare Teil ist kleiner als 10 px und wird bewusst nicht annotiert.
- Laufzeit: 60 annotierte Bilder, 10 Szenen; Apple M5 Pro (24 GB), nur CPU, Eigenbewegung vorab berechnet; Wanduhrzeit. 4K-Quelle und 720p-Proxy wurden mit derselben Anfrage verglichen; die aus beiden gemessene Eigenbewegung wich um höchstens 0,9 % ab.
- Asset-Zahl: Zählung des Bibliotheksordners der automatisch qualitätsgeprüften Assets; 657 Bilder, 57–109 je Klasse (26. September 2026).
- Der Beitrag synthetischer Daten zur Erkennungsleistung im Feld ist noch nicht gemessen. Dafür werden echte Testclips von der Erzeugung zurückgehalten und annotiert; vorher wird keine Genauigkeitsaussage veröffentlicht.
- Grenzen: Ohne sichtbare Schienen kann das Ego-Path-Modell keinen Korridor bestimmen (Gleis vollständig unter Schnee, im Tunnel); solche Clips verwirft die Qualitätsprüfung. Das Eigenbewegungsmodell setzt eine ebene Bodenfläche voraus; starke Neigungswechsel stören die Linearität. Nacht- und Wärmebildkameras sind nicht Teil dieser Arbeit.
- Verwendete offene Modelle: TEP-Net für den Ego-Path (Railenium; Code MIT, Gewichte CC BY-NC-SA 4.0, kommerzielle Nutzung erfordert Nachtraining unter passender Lizenz), SDXL und BiRefNet für Hindernisbilder. Die vollsynthetische Blender-Szene ist ein separater Erzeugungsweg.
Quellen
- 1.Laurent, T. (2024). Train Ego-Path Detection on Railway Tracks Using End-to-End Deep Learning. arXiv:2403.13094
- 2.TEP-Net-Code (MIT) und Ego-Path-Gewichte (CC BY-NC-SA 4.0)
- 3.Zendel et al. (2019). RailSem19: A Dataset for Semantic Rail Scene Understanding. CVPR Workshops
- 4.Podell et al. (2023). SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis. arXiv:2307.01952
- 5.Zheng et al. (2024). Bilateral Reference for High-Resolution Dichotomous Image Segmentation (BiRefNet). arXiv:2401.03407
Haben Sie Führerstandsaufnahmen, und fehlen Ihrem Hindernisdetektor Daten für seltene Szenarien?
In einer kostenlosen technischen Bewertung prüfen wir gemeinsam Ihre Führerstandsaufnahmen, Ihre Hindernisklassen und die Szenarien, in denen Ihr Modell an seine Grenzen stößt.
* F&E-/Fähigkeitsfall. Die Zahlen hat Spikedge auf den genannten Clips und der genannten Hardware gemessen; sie sind keine im Feld validierte Erkennungsgenauigkeit. Der Beitrag synthetischer Daten auf einem echten Testdatensatz ist noch nicht gemessen.